分析一条广告,和检查一条广告,不是一回事
我们总觉得,一个工具只要惊艳过我们一次,就值得我们次次信任。通常,事实恰恰相反。
这周我看到一位从业者发了篇帖子,履历里的数字很有分量:“Claude 几分钟就能做出 20 条 Meta 广告。一个连接器,把 1 条跑赢的广告变成你的 20 条广告。”22 个工具,5 个阶段,粘贴一个 URL。这个东西确实做得不错,大家为它兴奋也完全合理。
但真正留在我脑子里的,是里面另一句话。帖子提到,“到了那个明确的节点,它会停下来,把决定权交还给你。”整个系统的目标,是高速生成,然后把判断交回给人。它其实悄悄承认了一件没人愿意说出口的事:现在,生成已经是容易的部分了。决定、检查,以及在真金白银花出去之前,必须有人相信结果的那一部分,最终还是落在了人身上。
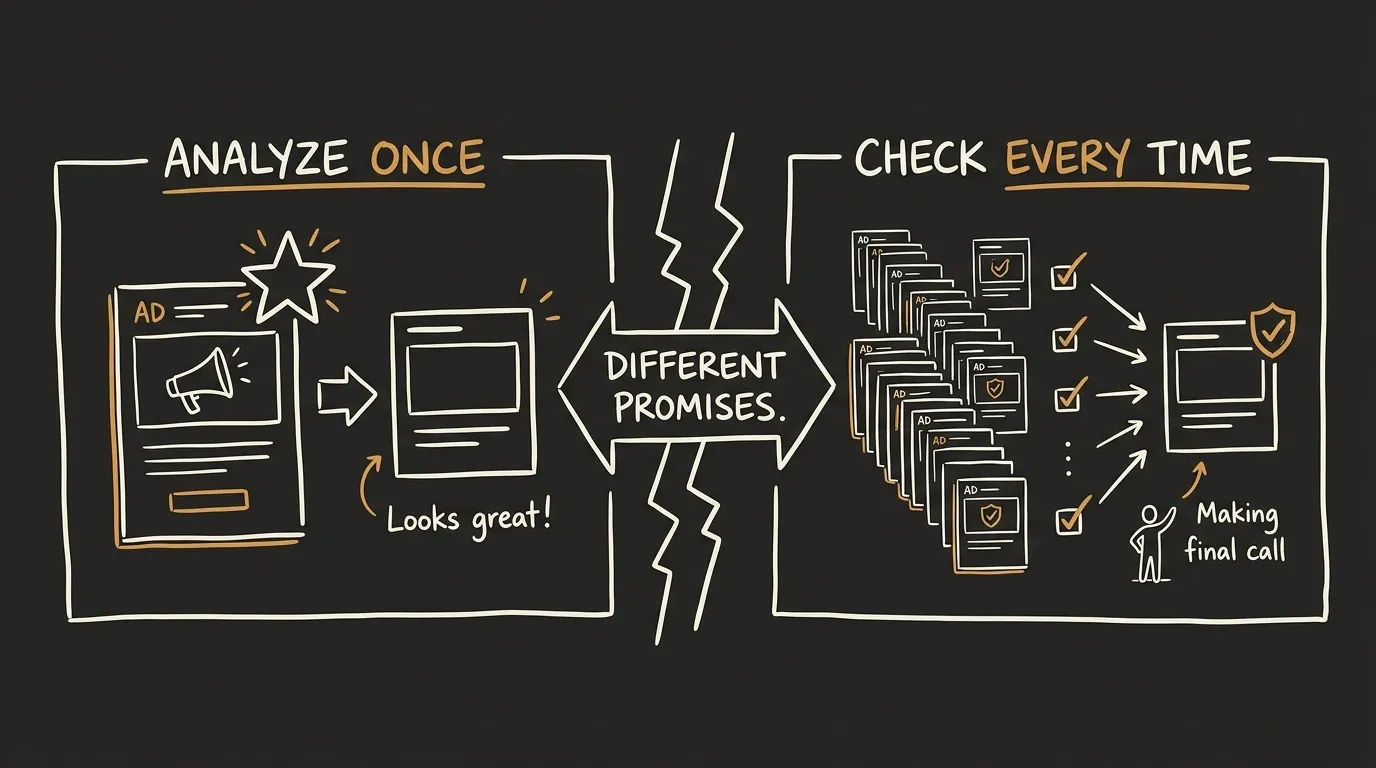
这就是我们一直混为一谈的差别。“AI 能分析这个”,说的是能力。“AI 值得信任,可以用来检查这个”,说的是可靠性。前者关心它发挥正常时会发生什么,后者关心它出错时会发生什么。演示永远只会给你看前一种情况。
我做的正是这个领域,所以花了很多时间待在这两者之间的缝隙里。里面藏着三件事。
第一件事,是工具究竟看见了什么。广告是一段视频,而决定它是否有效的东西都发生在时间里:开头两秒的钩子,结尾的 CTA,与旁白互相矛盾的字幕。把视频交给一个读取文字和图片的工具,它真正收到的,只是几帧画面和一份转录文本。然后它自信地给出对广告的判断。但它从来没有真正看过那条广告。它看到的只是广告投下的影子。这不是优化提示词就能解决的问题,而是模态感知能力的边界。
第二件事更奇怪,也更容易被忽略。我们想当然地认为,一个“检查工具”就应该是可靠的。但大模型本质上是概率性的。即使温度设为零,对同一份输入运行两次,有些答案依然会变化。模型并不会执行你的规则。它只是在做一次自信的猜测,而且即使猜错了,也不会告诉你它其实并不确定。对于创意工作,这种变化是一项能力;对于检查工作,它就是问题本身。一个会凭空编出问题的检查工具,给你的不是证据。它给你的是“看起来像证据的东西”。这反而更糟,因为你真的会据此行动。
真正认真做这件事的从业者早就明白这一点。一位负责医疗和金融科技账户 QA 的创意策略师告诉我,他会自动化低风险检查,但高风险检查仍然坚持人工完成。用他的话说,他依然不会“相信 LLM 能替我做出一个可能导致账户被封的最终决定”。这不是守旧。他只是算过这笔账:错误自动化的代价,远高于它省下的那几分钟。这个直觉是对的,也指出了工具应该怎样工作:模型负责标记,人负责决定。模型永远不是最后一句话。
第三件事只有到了规模化之后才会暴露,所以演示里永远看不到。把一条广告丢进聊天窗口,你会得到一个很好的答案。把四十条广告放进去,你会得到四十个答案:每条用词略有不同,分类不断漂移,结果之间根本无法对齐。真正的 Skill 从来不在工具里,而在操作它的人脑子里。那个人知道该怎么提问,也看得出答案什么时候不对。真正的质量层其实是他。等他忙起来,检查质量就会下降;等他离开,检查能力也跟着离开。一个只存在于某个人脑子里的能力,不是流程,而是依赖。
这些并不说明 Skills 不好。它们只是为另一种工作打造的另一类工具。大多数 Skill 都是为了生成而设计的,而生成奖励的是范围:发散、有创造力、没有唯一正确答案。检查恰恰是相反的纪律。它必须收敛、必须严格,而且必须正确。让一个最擅长创造选项的工具同时负责验证这些选项,等于要求一种本能去完成与它相反的工作。
这也指向了所有兴奋背后藏着的那件事。我们生成创意的速度越快,就会有越多创意在没有独立检查的情况下直接上线。瓶颈悄悄地从“做出内容”转移到了“相信内容”。而信任不是一个演示问题。它是一个系统问题:模型负责标记,确定性的机制负责验证,人仍然做出最终决定。
这就是为什么我最后选择沿着这条线构建产品,而不是发布一个 Skill。不是因为 Skill 不能对一条广告说出聪明的话,而是因为,偶尔聪明一次和每次都值得信任,是两种完全不同的承诺。只有一种是产品。
如果你在做付费投放,想看看这种检查在哪些地方经得住考验、又会在哪些地方失效,Preflite 目前正在 preflite.info 免费测试。